Metodi di rilevazione dell'overselling VPS: prova pratica con Steal Time e crollo della cache disco
L'overselling è un fenomeno comune nel settore VPS, ma un overselling eccessivo può influire notevolmente sulle prestazioni. Questo articolo, partendo dalle due dimensioni del CPU Steal Time e del crollo della cache disco, fornisce un metodo di rilevazione operativo per aiutarti a capire se il tuo VPS è eccessivamente overselling e offre strategie di risposta.
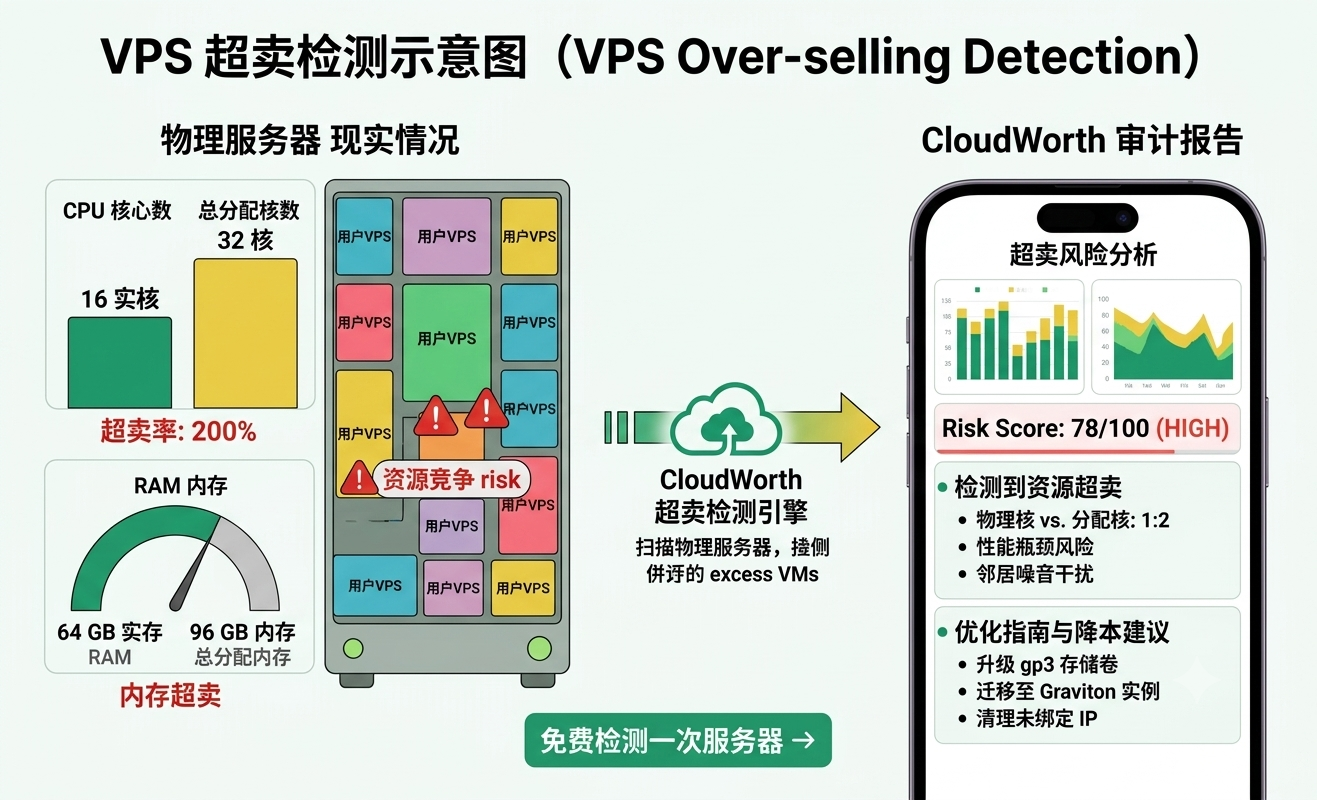
Monitorando costantemente il CPU Steal Time e i fenomeni di crollo della cache disco, insieme a test di stress, è possibile identificare efficacemente i VPS eccessivamente overselling, limitare le perdite e ottimizzare la strategia di distribuzione.
Perché è necessario rilevare l'overselling dei VPS?
I VPS (Virtual Private Server) derivano dalla partizione delle risorse fisiche del server tramite tecnologie di virtualizzazione. L'overselling (sovrallocazione) si riferisce alla situazione in cui la somma delle risorse virtuali vendute dal provider supera il limite delle risorse fisiche; è una pratica comune nel settore IDC. Un overselling ragionevole può ridurre i costi, ma un overselling eccessivo può causare contesa della CPU, picchi di latenza I/O del disco e persino problemi di "vicini rumorosi".
Come utenti, non possiamo visualizzare direttamente la configurazione di overselling del provider, ma possiamo dedurla indirettamente attraverso i pattern di variazione degli indicatori di sistema. Tra questi, CPU Steal Time e il crollo della cache del disco sono i due segnali più diretti ed efficaci.
Indicatore chiave 1: CPU Steal Time (tempo rubato)
Cos'è lo Steal Time?
Nei sistemi Linux, il campo steal o st rappresenta la percentuale di tempo in cui la CPU della macchina virtuale viene sottratta dall'Hypervisor (host). Quando le risorse della CPU fisica sono insufficienti, l'host forza la schedulazione, facendo sì che il tuo VPS non ottenga il tempo di CPU che gli spetta. Questo periodo di attesa è lo Steal Time.
Uno Steal Time troppo alto significa che il tuo VPS è 'in coda per la CPU' e le prestazioni ne risentono.
Come vedere lo Steal Time?
Usa il comando top e controlla il valore st nella riga %Cpu(s):
top -n 1 | grep '%Cpu'Esempio di output:
%Cpu(s): 5.1 us, 2.0 sy, 0.0 ni, 92.0 id, 0.0 wa, 0.9 hi, 0.0 si, 0.0 stQui st è lo Steal Time. Puoi anche usare il comando vmstat guardando la colonna st (richiede i permessi di root):
vmstat 1 5Soglie di valutazione
- Superiore al 5% in modo continuativo: indica che la CPU dell'host è sovraccarica e la tua VPS inizia a subirne gli effetti.
- Picchi superiori al 10%: possono verificarsi evidenti cali di prestazioni, soprattutto per attività che richiedono calcolo continuo.
- Oltre il 20% per un periodo prolungato: rappresenta un overselling grave, si consiglia di valutare un cambio di provider.
Simulazione di stress test
Osservare semplicemente lo Steal Time a riposo potrebbe non essere significativo. Si consiglia di utilizzare lo strumento stress per simulare il carico della CPU e osservare il comportamento dello Steal Time sotto stress:
# 安装stress(Debian/Ubuntu)
apt install stress -y

# 满载所有CPU核心60秒
stress --cpu $(nproc) --timeout 60 &

# 同时运行top观察
sleep 5 && top -d 2 | grep '%Cpu'
Se in condizioni di pieno carico il valore st sale alle stelle, significa che le risorse fisiche della CPU sono state fortemente contese da altre VPS, indicando un overselling grave.
Secondo indicatore chiave: il precipizio della cache del disco
Cos'è il "precipizio" della cache del disco?
Le prestazioni I/O del disco di un VPS dipendono fortemente dalla cache nella memoria dell'host. Quando la cache viene colpita (hit), la velocità di lettura/scrittura è estremamente rapida; quando non viene colpita (miss), soprattutto in caso di picchi di lettura/scrittura, la velocità del disco fisico diventa il collo di bottiglia e le prestazioni calano di diversi ordini di grandezza, creando un "precipizio".
Se sull'host vengono eseguiti troppi VPS, la proporzione di cache disponibile per ogni VPS diminuisce, rendendo più facile innescare l'effetto precipizio.
Come rilevare il calo improvviso della cache del disco?
Usa hdparm o dd per testare la velocità di lettura/scrittura del disco e osserva le fluttuazioni di velocità.
1. Test semplice:
# 写入测试(512MB文件)
time dd if=/dev/zero of=testfile bs=1M count=512 conv=fdatasync

# 读取测试(清缓存后)
echo 3 > /proc/sys/vm/drop_caches   # 需要root,清Page Cache
time dd if=testfile of=/dev/null bs=1M count=512
Registra la differenza di velocità tra il primo test e i test successivi. Se la velocità di scrittura iniziale è molto elevata (a causa della cache di scrittura), ma poi cala bruscamente, significa che la capacità della cache è limitata e la contesa è elevata.
2. Usare fio per un test più preciso:
# 安装fio(Debian/Ubuntu)
apt install fio -y

# 4K随机写测试,持续60秒
fio --name=randwrite --ioengine=libaio --rw=randwrite --bs=4k --size=1G --numjobs=4 --iodepth=16 --runtime=60 --time_based --direct=1 --group_reporting
Osserva attentamente la distribuzione di lat (usec) e iops. Se la curva di latenza presenta forti oscillazioni, significa che quando la cache non viene utilizzata le prestazioni del disco fisico sono estremamente instabili.
Metodo di rilevamento del precipizio
Esegui più volte test di lettura/scrittura di piccoli file, registrando ogni volta IOPS o throughput. Ad esempio:
for i in {1..10}; do
  dd if=/dev/zero of=testfile bs=1M count=64 oflag=direct 2>&1 | tail -1
  rm testfile
done
Se la velocità scende improvvisamente da centinaia di MB/s a decine di MB/s, e questo accade frequentemente, puoi diagnosticare un precipizio della cache del disco.
Altri metodi di rilevamento ausiliari
1. Disponibilità di memoria
L'overselling può verificarsi anche sulla memoria. Usa free -h per osservare la memoria disponibile. Se è spesso inferiore al 10% e lo swap è chiaramente utilizzato, significa che anche la memoria è oversold.
2. Test di concorrenza dei vicini
Prova a eseguire test di stress in periodi specifici (ad esempio, nelle ore di punta serali), confrontando il Steal Time con i periodi di inattività. Se gli indicatori peggiorano in modo evidente nelle ore di punta, ciò corrobora ulteriormente l'overselling.
3. Monitoraggio a lungo termine
Si consiglia di usare sar o atop per registrare continuamente le metriche di sistema, monitorando per almeno una settimana. Prestare attenzione alle fluttuazioni delle prestazioni negli orari fissi settimanali.
# 使用sar记录CPU历史(需要安装sysstat)
sar -u 60 > /tmp/cpu_history.log &
Come affrontare l'overselling?
- Evita le ore di punta: per le attività non in tempo reale, pianifica le attività nelle fasce orarie di bassa richiesta.
- Aggiungi cache: aggiungi cache come Redis a livello applicativo per ridurre la dipendenza dall'I/O del disco sottostante.
- Cambia fornitore: se lo Steal Time è elevato per un lungo periodo, migra decisamente verso un cloud provider che non oversella o con una percentuale di overselling inferiore.
- Scegli piani ad alte prestazioni: alcuni fornitori offrono VPS con "CPU dedicata" o "overselling limitato", con costi più elevati ma prestazioni più stabili.
Consigliamo di utilizzare strumenti di rilevamento professionali per la valutazione prima dell'acquisto. Puoi ottenere lo script di rilevamento automatizzato nella pagina di istruzioni e generare con un clic un rapporto dettagliato sull'overselling.
Conclusione
Il rilevamento dell'overselling VPS non è un'operazione una tantum, ma richiede un monitoraggio continuo. Attraverso i due indicatori chiave Steal Time e il crollo della cache del disco, combinati con stress test e registrazioni a lungo termine, puoi determinare efficacemente se il tuo VPS attuale è sovravenduto in modo eccessivo, e quindi decidere se aggiornare o migrare.
Ricorda, nessun singolo indicatore può determinare al 100% l'overselling, ma combinando dati da più dimensioni, puoi vedere chiaramente la verità.
Spero che questa guida pratica ti aiuti a evitare errori nella scelta di un VPS. Se stai pensando di cambiare provider, ti consiglio di testare prima il server attuale seguendo i metodi di questo articolo, e poi confrontare i risultati con quelli del provider target.